Hur mycket minne behöver en språkmodell? VRAM och kvantisering
Kortfattat: En tumregel är att en språkmodell som är kvantiserad till Q4 behöver ungefär två tredjedelar så många GB som den har miljarder parametrar. En 8B-modell kräver alltså ca 5–6 GB och en 70B-modell knappt 50 GB. Långa samtal tar extra plats. Längre ner kan du räkna ut om en modell ryms på din dator.
Vad betyder 8B, 30B och 70B?
Siffran står för antalet parametrar i miljarder (B som i billion). Parametrarna är de tal som modellen lärt sig under träningen, ungefär som hjärnans kopplingar. Fler parametrar ger oftast smartare svar, men kräver mer minne och går långsammare.
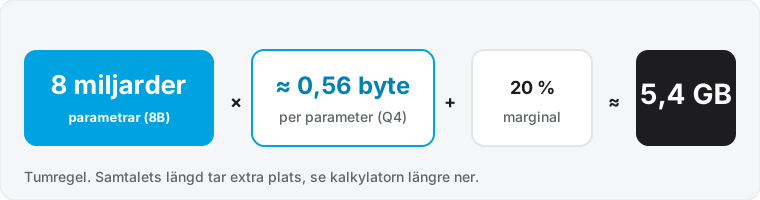
Så räknar du ut hur mycket minne en modell behöver.
Vad är kvantisering?
I originalform lagras varje parameter med 16 bitar. Kvantisering betyder att man avrundar talen så att de tar mindre plats. Med Q8 tar modellen ungefär halva utrymmet och med Q4 knappt en tredjedel. Kvaliteten sjunker lite, men oftast så lite att du inte märker det i vardagen.
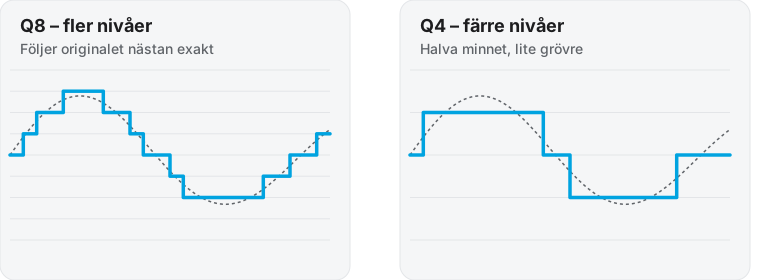
Kvantisering avrundar modellens värden till färre nivåer. Streckad linje = originalet, blå = det modellen sparar. (Förenklad illustration.)
| Format | Minne per miljard parametrar | Kvalitet | När ska jag välja det? |
|---|---|---|---|
| FP16 | ca 2 GB | Original | När du finjusterar med LoRA (kapitel 9) |
| Q8 | ca 1 GB | Nästan som originalet | När minnet räcker och kvalitet är viktigast |
| Q4 | ca 0,6 GB | Lite sämre, sällan märkbart | Standardvalet för de flesta |
Så mycket minne behöver modellerna
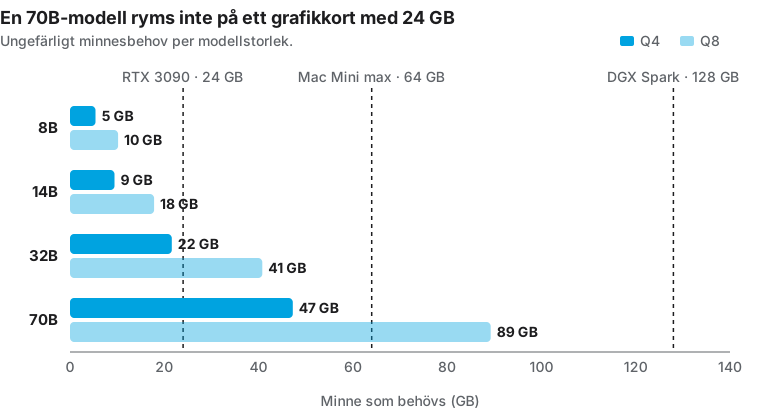
Beräknat med tumregeln ovan, utan extra plats för långa samtal.
Diagrammet visar varför vi använder tre storlekar i serien. Ett RTX 3090 kör 8B- och 14B-modeller snabbt, och 32B-modeller i Q4 så länge samtalen är korta. En 70B-modell kräver DGX Spark eller en Mac med mycket minne.
Får modellen plats? Räkna själv
Modellstorlek
Kvantisering
Samtalslängd
Uppskattning: modell × byte per parameter + 20 % marginal + plats för samtalet. Verklig användning varierar mellan modeller. Mac Mini och DGX Spark delar minnet med systemet, så vi räknar försiktigt med att ca 75 % kan användas av språkmodellen.
Vad är tokens och kontextlängd?
Språkmodeller läser och skriver inte hela ord, utan tokens: bitar av ord. Hastighet mäts därför i tokens per sekund. Ett vanligt ord är ofta en token, medan långa svenska sammansättningar kan bli flera.
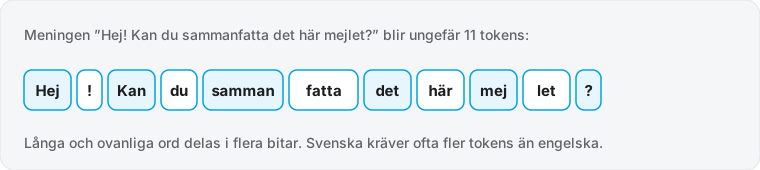
Exempel. Exakt uppdelning beror på modellen.
Kontextlängd är hur många tokens modellen kan hålla i huvudet samtidigt: din fråga, tidigare svar och eventuella dokument. Ju längre kontext, desto mer minne går åt. Det är därför kalkylatorn ovan frågar efter samtalslängd.
MoE-modeller: stora men snabba
Vissa moderna modeller är byggda som en Mixture of Experts (MoE). Modellen består av många mindre experter, och för varje token väljs bara några av dem. Hela modellen måste rymmas i minnet, men den räknar bara på en liten del. Qwen3-30B-A3B har till exempel 30 miljarder parametrar men använder bara ca 3 miljarder per token, och svarar därför ungefär lika snabbt som en liten modell.
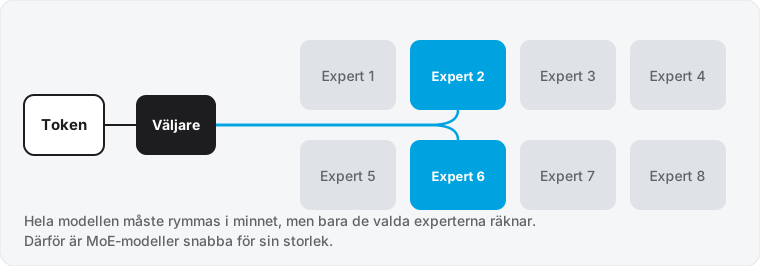
Förenklad bild av en MoE-modell (Mixture of Experts).
Välj det som passar dig:
Vad betyder det för dig hemma?
- 8–12 GB grafikminne: 8B-modeller i Q4 fungerar bra för chatt och sammanfattningar.
- 24 GB (RTX 3090 eller Mac Mini 32 GB): upp till ca 30B-modeller, märkbart smartare svar.
- Mer än så behövs sällan hemma, om du inte vill köra de allra största modellerna.
Börja med Q4. Byt till Q8 om du har minne över och vill ha lite bättre svar.
Vad betyder det för företaget?
När flera anställda använder samma AI-server har varje samtal sin egen kontext, och varje kontext tar minne. Räkna därför inte bara på modellen utan också på hur många som ska använda den samtidigt.
- Modellen laddas en gång och delas av alla.
- Samtalen tar extra minne per användare. Tio samtidiga långa samtal kan kräva lika mycket som själva modellen.
- Dokumentsök (kapitel 7) skickar med textutdrag i varje fråga, vilket gör kontexten längre.
Därför rekommenderar vi DGX Spark med 128 GB för ett kontor, även om modellen i sig skulle rymmas på mindre.
Ordlista
Parametrar
De tal modellen lärt sig. Anges i miljarder: 8B, 70B.
VRAM
Grafikkortets eget minne. Snabbt, men begränsat (24 GB på RTX 3090).
Delat minne (unified memory)
Minne som delas mellan processor och grafikdel, som i Mac Mini och DGX Spark.
Kvantisering
Att avrunda modellens tal så att den tar mindre plats. Q4 och Q8 är vanliga nivåer.
Token
En bit av ett ord. Språkmodeller läser och skriver i tokens.
Kontextlängd
Hur mycket text modellen kan hålla i huvudet samtidigt.
MoE
Mixture of Experts. En modell där bara en del av experterna används för varje token.
Vanliga frågor
Hur mycket VRAM behövs för AI?
För att köra en språkmodell lokalt räcker 8–12 GB för att komma igång. Med 24 GB kan du köra modeller upp till ca 30B i Q4. För 70B-modeller behövs runt 50 GB eller mer.
Blir svaren mycket sämre med Q4?
Oftast inte märkbart i vardagliga uppgifter. Skillnaden syns mest i svåra resonemang och kod. Har du minne över, välj Q8.
Vad händer om modellen inte ryms?
Programmen kan lägga en del av modellen i datorns vanliga minne, men då blir den mycket långsammare. Välj hellre en mindre modell eller kraftigare kvantisering.
Räknas datorns vanliga RAM-minne?
På en Mac och på DGX Spark, ja, eftersom minnet är delat. På en vanlig PC är det grafikkortets minne som gäller om språkmodellen ska gå snabbt.
Behöver du mer minne?
Vi hjälper dig att hitta en dator eller ett grafikkort med rätt mängd minne för de modeller du vill köra.
Nästa kapitel: Installera lokal AI på Windows, Mac och Linux
